Behind AS204197 – Das Kabel ist weg. Und jetzt?
Ein Cross-Connect wird versehentlich gezogen. Eine Optik fällt aus. Oder ein vorgeschalteter Carrier hat eine Störung.
Für uns als Netzbetreiber stellt sich dann eine sehr konkrete Frage: Über welchen Weg erreichen die Pakete jetzt ihr Ziel?
Für unsere Kunden ist die Frage eine andere: Läuft die Videokonferenz weiter? Bleibt die Verbindung zum Terminalserver bestehen? Funktioniert die Cloud-Anwendung noch?
Zwischen diesen beiden Perspektiven liegt der Unterschied zwischen „Wir haben mehrere Internetleitungen“ und einer durchdachten Redundanzarchitektur.
Schauen wir uns deshalb an, was bei einem Uplink-Ausfall passiert – vom ersten erkannten Fehler bis zum Verkehr auf dem alternativen Pfad. An einigen Stellen werfen wir dabei auch einen Blick auf die Routing-Filter, mit denen wir dieses Verhalten steuern.
Unser Ausgangspunkt: Ein Internetzugang besteht aus mehreren Ebenen
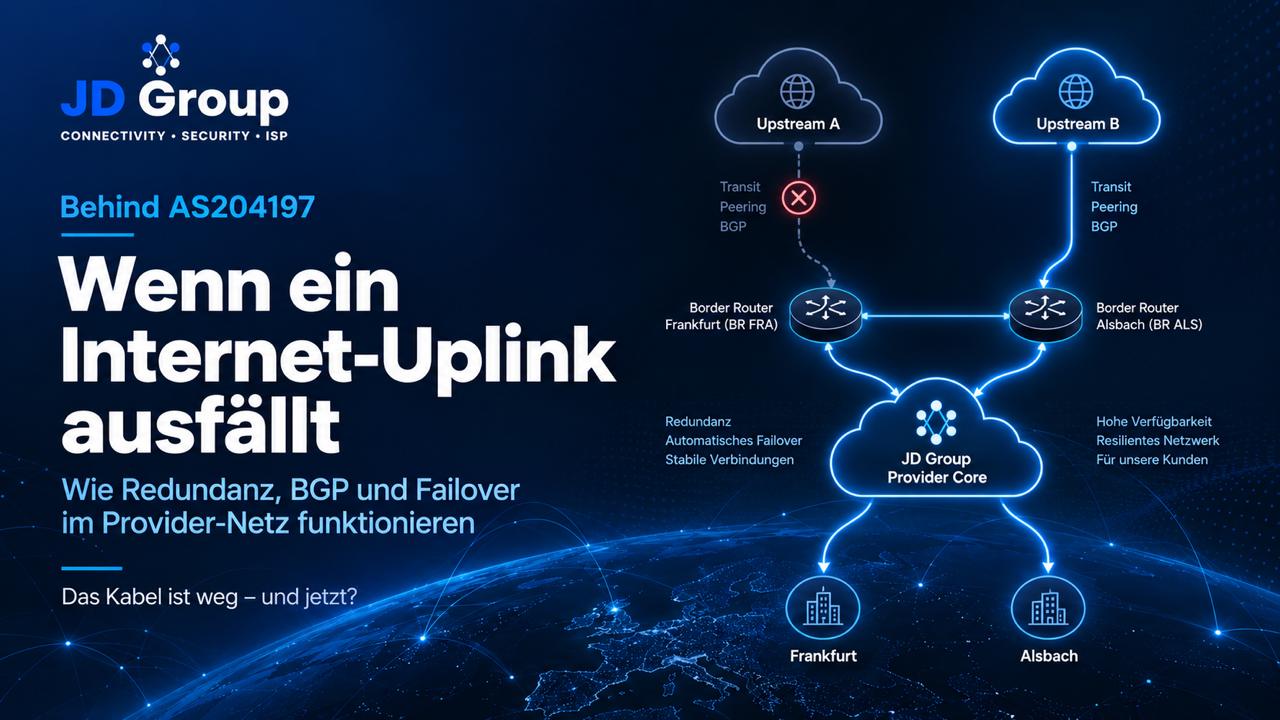
Unser Netz AS204197 verbindet unter anderem die Standorte Frankfurt und Alsbach. Innerhalb unserer Infrastruktur trennen wir die Aufgaben: Die BNGs terminieren die Teilnehmerverbindungen, unser MPLS-Backbone transportiert die Dienste zwischen den Systemen, und die Border-Router übernehmen die Anbindung an andere Netze über Transit und Peering.
Diese Aufgabentrennung ist für den Fehlerfall entscheidend. Ein ausgefallener Internet-Uplink ist zunächst nicht dasselbe wie ein ausgefallener BNG, eine unterbrochene Backbone-Verbindung oder eine gestörte Kundenleitung.
Für unseren Walkthrough nehmen wir einen konkreten Fall:
Ein Kunde ist über unseren BNG in Frankfurt verbunden. Sein Verkehr zu einem bestimmten Internetziel verlässt unser Netz über einen Transit-Uplink am Frankfurter Border-Router. Genau dieser Uplink fällt aus.
Für dieses Ziel ist in unserem Beispiel kein höher priorisierter Peering-Pfad verfügbar. Ein alternativer Transitpfad steht dagegen bereit.
Der BNG läuft weiter. Der Backbone ist erreichbar. Andere Internetanbindungen funktionieren.
Wir betrachten also einen Uplink-Ausfall – nicht den gleichzeitigen Ausfall eines ganzen Standorts.
1. Zuerst muss der Router erkennen, dass der Weg nicht mehr funktioniert
„Das Kabel ist weg“ klingt eindeutig. Technisch hängt die Erkennung aber davon ab, wo der Fehler auftritt.
Wird die unmittelbar angeschlossene Glasfaser getrennt, kann die Schnittstelle ihren Linkstatus verlieren. Das liefert ein direktes Fehlersignal.
Unangenehmer ist ein Fehler hinter einem weiterhin funktionierenden Switch oder innerhalb einer Carrier-Strecke. Der lokale Ethernet-Port kann dann weiterhin „Link up“ anzeigen, obwohl die Gegenstelle nicht mehr erreichbar ist. Genau deshalb reicht der Interface-Status allein nicht als Funktionsnachweis für eine Verbindung.
Bei BGP überwacht unter anderem der ausgehandelte Hold Timer, ob die Gegenstelle weiterhin gültige KEEPALIVE- oder UPDATE-Nachrichten liefert. Bleiben diese lange genug aus, wird die Session beendet. Ein erkannter TCP-Verbindungsfehler kann den Abbau ebenfalls auslösen.
Wo beide Seiten es unterstützen und entsprechend konfigurieren, kann Bidirectional Forwarding Detection, kurz BFD, die Erkennung eines ausgefallenen Verbindungspfads beschleunigen.
BFD ist allerdings kein Test des gesamten Internets. Eine funktionierende BFD-Verbindung zur Gegenstelle beweist nicht, dass hinter dieser Gegenstelle jedes Ziel erreichbar ist.
„Die BGP-Session ist aufgebaut“ und „unsere Kunden erreichen ihre Anwendungen“ sind zwei unterschiedliche Aussagen.
2. Der ausgefallene BGP-Pfad fällt aus der Auswahl
Sobald die BGP-Session als ausgefallen behandelt wird, werden die darüber gelernten Pfade im normalen BGP-Verhalten entfernt.
Dabei ist eine Unterscheidung wichtig: Über eine bereits unterbrochene Verbindung muss der Nachbar nicht noch für jedes Präfix eine Rückzugsmeldung schicken. Der Session-Abbruch selbst führt zur Entfernung der zugehörigen Routinginformationen.
Ein ausdrückliches Withdrawal wird dagegen verwendet, wenn ein Nachbar über eine weiterhin bestehende BGP-Session mitteilt, dass ein zuvor angekündigter Weg nicht mehr verfügbar ist. Gegenüber anderen funktionierenden BGP-Nachbarn werden anschließend die erforderlichen Änderungen bekannt gemacht.
Es verschwindet also nicht pauschal „das Internet“ aus dem Router. Es entfallen zunächst die Pfade, die von der betroffenen Verbindung abhängen.
Eine Ausnahme vom sofortigen Entfernen kann beispielsweise BGP Graceful Restart sein: Dabei können Routen während eines Control-Plane-Neustarts vorübergehend erhalten bleiben. Bei einem tatsächlichen Weiterleitungsausfall kann dieses Verhalten allerdings auch die Nutzung eines unbrauchbaren Pfads verlängern. Fehlererkennung und Graceful Restart müssen deshalb zusammenpassen.
3. Die Alternativen sollten bereits bekannt sein
An unseren Border-Routern verarbeiten wir vollständige Internet-Routingtabellen und zusätzliche Peering-Routen. Die entsprechenden BGP-Verbindungen bestehen bereits im Normalbetrieb.
Die Ersatzwege werden also nicht erst nach einem Fehler eingerichtet.
Aber: Eine empfangene Route ist nicht automatisch eine Route, die wir auch verwenden wollen.
Unsere Importfilter entscheiden zunächst, welche Routinginformationen zulässig sind. Anschließend versehen sie akzeptierte Pfade mit den Attributen, die unsere Pfadauswahl steuern.
Praxisbeispiel: Ein Transitpfad bekommt eine definierte Priorität
Ein auf seine wesentlichen Funktionen gekürzter Transit-Import sieht bei uns beispielsweise so aus:
Die Beispiele zeigen anonymisierte, funktionsbezogene Auszüge unserer RouterOS-7-Filter. Vollständige Schutzketten, Community-Verarbeitung und Sonderfälle sind nicht vollständig dargestellt.
Die Verarbeitung erfolgt in einer festgelegten Reihenfolge: Zuerst greifen die allgemeinen Eingangsprüfungen, anschließend die RPKI-Prüfung. Erst danach akzeptiert die gezeigte Regel reguläre IPv4-Präfixe im vorgesehenen Längenbereich und setzt deren Local Preference auf 100.
Andere Importregeln können andere Präferenzen vergeben. In unseren Filtern finden sich beispielsweise diese Gewichtungen:
- Regulärer Transitpfad – 100
- Ein regulärer IX-Peering-Pfad – 200
- Ein bevorzugtes direktes Peering – 250
Die Werte sind keine Geschwindigkeitsangaben und keine Entfernungen. Sie drücken eine Routing-Präferenz aus. Für dasselbe Präfix wird eine höhere Local Preference bevorzugt, sofern nicht bereits ein vorrangiges Auswahlkriterium entscheidet. Einzelne Peerings und Sonderfälle können von diesen Beispielen abweichen.
Wichtig ist dabei die Formulierung „für dasselbe Präfix“. Die Auswahl zwischen unterschiedlichen Präfixlängen ist eine andere Ebene: Bei der Paketweiterleitung gewinnt die passendste, spezifischste Route – das sogenannte Longest Prefix Match.
Was bedeutet das für unseren Ausfall?
In unserem Beispiel fällt der bisher bevorzugte Transitpfad weg. Der Router kann nun einen anderen zulässigen und erreichbaren Pfad für das Ziel auswählen.
Bei gleicher Local Preference entscheiden weitere BGP-Auswahlkriterien, beispielsweise die AS-Pfadlänge. Der Ersatzweg muss daher nicht für jedes Ziel derselbe sein.
Ein Ziel kann über einen anderen Frankfurter Transit erreichbar bleiben. Für ein anderes Ziel kann der nutzbare Ersatzweg über unseren Backbone und den Border-Router in Alsbach führen.
Und Verkehr, der ohnehin über ein nicht betroffenes Peering läuft, muss wegen des Transit-Ausfalls möglicherweise überhaupt nicht umgeschaltet werden.
Failover bedeutet nicht zwangsläufig, dass der gesamte Verkehr geschlossen auf eine einzige Reserveleitung wechselt.
4. Die Sicherheitsregeln bleiben auch im Fehlerfall bestehen
Ein wichtiger Bestandteil unserer Importverarbeitung ist die RPKI-Prüfung für reguläre Internet-Routen.
Der entsprechende Prüfschritt lässt sich auf wenige Zeilen reduzieren:
RPKI-VALIDATORS steht hier stellvertretend für die konfigurierte Validator-Gruppe.
Eine als Invalid bewertete Route wird verworfen. Das bedeutet nicht, dass ausschließlich Routen mit dem Status Valid akzeptiert werden: Eine Route ohne passenden RPKI-Nachweis ist nicht automatisch ungültig. Sie muss weiterhin die übrigen Importprüfungen bestehen. RPKI-Origin-Validation prüft außerdem nicht den gesamten AS-Pfad.
Auch das abschließende return; ist bewusst gewählt. Die Verarbeitung kehrt damit in die aufrufende Filterkette zurück. Ein accept; an dieser Stelle würde die Route bereits annehmen, statt die nachfolgenden Prüfungen weiterlaufen zu lassen.
Unsere allgemeine Schutzkette weist unter anderem unerwünschte Default-Routen, private beziehungsweise besondere Adressbereiche und bestimmte unzulässige AS-Pfade zurück.
Für den Fehlerfall folgt daraus:
Ein Pfad wird nicht plötzlich akzeptabel, nur weil gerade eine andere Verbindung ausgefallen ist.
Die Alternative muss schon nach der regulären Policy zulässig sein. Es gibt keinen automatischen Notfallmodus, der vorsorglich sämtliche Filter öffnet.
5. Eine neue Routingentscheidung muss auch in der Weiterleitung ankommen
Über bestehende Sessions bereits gelernte Alternativen können weiterverwendet werden. Dafür muss nicht zunächst von sämtlichen Nachbarn die komplette Internettabelle neu übertragen werden. BGP arbeitet nach dem initialen Austausch grundsätzlich mit Änderungen.
Trotzdem ist „Ersatzroute bekannt“ nicht dasselbe wie „Pakete werden bereits erfolgreich darüber weitergeleitet“.
Die Routingentscheidung muss in der Forwarding-Tabelle wirksam werden. Erst dann verlassen die betroffenen Pakete den Router tatsächlich auf dem neuen Weg. Deshalb unterscheiden wir zwischen der Konvergenz der Control Plane und der Wiederherstellung der Paketweiterleitung in der Data Plane.
Ein passender Logeintrag ist hilfreich. Der entscheidende Nachweis bleibt aber der funktionierende Datenverkehr.
Und was passiert währenddessen auf dem BNG?
Hier zahlt sich die Aufgabentrennung unserer Architektur aus.
Unsere BNGs müssen nicht für jedes Internetziel zwischen Transitpartnern und Peerings wählen. Sie erhalten für den Internetdienst Default-Routen von den Border-Routern. Das Konzept sieht den lokalen Standort als bevorzugten Ausgang und den anderen Standort als Alternative vor.
Verliert der Frankfurter Border-Router einen Uplink, erreicht das Ziel aber weiterhin über andere Pfade, muss sich für den BNG zunächst nichts ändern.
Der BNG schickt die Pakete weiterhin zum Internet-Edge. Erst dort ändert sich der weitere Weg.
Praxisbeispiel: Gezielt eine Default-Route an den Core übergeben
Auch diese Aufgabentrennung findet sich in unseren Filtern wieder. Ein gekürzter Ausschnitt aus dem Default-Export lautet:
Interne Standortmarkierungen sind in diesem Beispiel weggelassen.
Der Filter begrenzt diese Übergabe auf eine Default-Route, bei der ein ICMP-Gateway-Check eingestellt ist. Die vollständigen Internet-Routingtabellen werden über diese Filterkette nicht an die nachgelagerten Systeme weitergegeben.
Dabei darf man gw-check icmp nicht falsch lesen: Die Bedingung prüft eine Eigenschaft der Route. Sie führt nicht selbst einen neuen Ping aus und bestätigt keine vollständige Internet-Erreichbarkeit. Welche Route aktiv und exportierbar ist, entscheiden Routing und Exportauswahl.
Ein noch erreichbares Gateway kann schließlich selbst ein Problem mit seinen weiteren Verbindungen haben. Gateway-Erreichbarkeit und tatsächliche Dienstverfügbarkeit müssen deshalb getrennt betrachtet werden.
Dass wir auf bestimmten externen BGP-Sessions Default-Routen ablehnen und intern gezielt Default-Routen verteilen, ist übrigens kein Widerspruch: Außen kontrollieren wir, welche Routinginformationen wir von anderen Netzen übernehmen. Innen definieren wir, welche Informationen unsere eigenen Systeme für ihre Aufgabe benötigen.
Am Internet-Edge detailliert entscheiden, im nachgelagerten Netz gezielt vereinfachen.
6. Auch der Rückweg muss funktionieren
Bis hierhin haben wir hauptsächlich betrachtet, wie Pakete unser Netz verlassen.
Eine Verbindung funktioniert aber nur, wenn auch die Antworten zurückkommen.
Die öffentliche Erreichbarkeit darf deshalb nicht ausschließlich am ausgefallenen Uplink hängen. Beim BGP-Multihoming werden die relevanten Präfixe über mehrere Anbindungen bekannt gemacht, sodass andere Netze alternative Wege zu denselben Adressen erhalten können.
Welchen davon sie verwenden, entscheiden die beteiligten Netzbetreiber anhand ihrer eigenen Routing-Policies. Wenn unser Router bereits einen Ersatzweg verwendet, müssen deshalb noch nicht alle betroffenen externen Netze ihre Pfadänderungen abgeschlossen haben. Hin- und Rückweg können außerdem über unterschiedliche Carrier verlaufen.
Praxisbeispiel: Nach außen geht nicht einfach unsere gesamte Routingtabelle
Für diese Ankündigungen sind unsere Exportfilter entscheidend.
Auf den Anteil für eigene IPv4-Netze reduziert, sieht das Prinzip so aus:
OWN-PREFIXES-V4 steht für die ausdrücklich freigegebene Liste eigener Präfixe. Die konkreten Netze sind hier nicht dargestellt.
Die gezeigte Regel erlaubt also nicht pauschal „alle statischen Routen“, sondern ausschließlich passende Präfixe aus dieser Freigabeliste.
Unsere vollständigen Exportketten berücksichtigen zusätzlich autorisierte Kundennetze. Dafür werden weitere Kriterien wie das freigegebene Präfix, die Präfixlänge, der erwartete AS-Pfad und die entsprechende interne Kennzeichnung geprüft.
Das Ziel ist klar: Eigene Netze und ausdrücklich autorisierte Kundennetze dürfen angekündigt werden. Beliebige, von anderen Upstreams oder Peerings gelernte Internet-Routen nicht.
Diese Trennung verhindert, dass aus einer Ausweichverbindung unbeabsichtigt ein Transitangebot zwischen fremden Netzen wird. Die Beschränkung solcher Exporte ist ein wesentlicher Bestandteil der Route-Leak-Prävention.
Auch im Fehlerfall ändern wir daran nichts. Der alternative Uplink soll unsere Erreichbarkeit übernehmen – nicht plötzlich fremde Routinginformationen ungefiltert weiterverteilen.
Warum ein Internet Exchange nicht einfach ein weiterer Transit ist
Für den Fehlerfall ist auch die Art der verbleibenden Anbindungen wichtig.
Ein Full-Transit-Anschluss soll grundsätzlich die Erreichbarkeit des globalen Internets bereitstellen. Über ein Peering erhalten wir dagegen die Netze, die der jeweilige Partner innerhalb dieser Beziehung ankündigt – typischerweise eigene Netze und Kundennetze.
Ein Peering-Port an einem Internet Exchange wie DE-CIX oder LOCIX ist deshalb nicht automatisch ein vollständiger Ersatz für sämtliche Transitverbindungen.
Für Ziele mit einem nutzbaren Peering-Pfad kann die Erreichbarkeit darüber erhalten bleiben. Für andere Ziele wird weiterhin ein funktionierender Transitpfad benötigt.
Auch ein Route Server ändert daran nichts. Er vermittelt Routinginformationen zwischen Teilnehmern; die Nutzdaten laufen nicht durch ihn. Zwei Route-Server-Sessions ersetzen deshalb keine zweite physische Anbindung an den Exchange.
Für die Redundanzplanung zählen somit nicht nur die Anzahl der BGP-Sessions, sondern auch die darüber erreichbaren Netze und die tatsächlichen Transportwege.
Brechen bestehende Kundenverbindungen dabei ab?
Nicht zwangsläufig. Eine BGP-Session ist keine Kundensession.
Die ausgefallene BGP-Session verbindet in unserem Beispiel zwei Router zum Austausch von Routinginformationen. Die PPPoE-Session des Kunden endet dagegen auf unserem BNG.
Solange der BNG und die Teilnehmerzuführung weiter funktionieren, muss ein reiner Uplink-Wechsel diese PPPoE-Session nicht beenden. Eine erneute Einwahl ist nicht allein wegen des geänderten Internetpfads erforderlich.
Gleiche IP-Adresse, anderer Weg
Bei einer bestehenden TCP-Verbindung gehört die Folge der durchlaufenen Router nicht zur Identität der Verbindung. Bleiben die Endpunkte und der Verbindungszustand erhalten und ist die Unterbrechung kurz genug, kann die Verbindung nach dem Pfadwechsel weiterlaufen. Verlorene Daten werden erneut übertragen.
Läuft dagegen ein relevanter Timeout ab, kann die Verbindung scheitern oder die Anwendung einen Neuaufbau verlangen.
Ein Download kann deshalb kurz pausieren und anschließend weiterlaufen. Eine interaktive Anwendung kann währenddessen spürbar hängen.
NAT und Firewalls sind eine zusätzliche Ebene
Wechselt nur der geroutete Internetpfad, muss sich an einer bestehenden NAT-Zuordnung nichts ändern.
Wechselt der Verkehr dagegen auf eine andere NAT-Instanz, die die bisherigen Zuordnungen nicht kennt, können bestehende Verbindungen abbrechen. Routing stellt diese Zustände nicht automatisch auf einem anderen System wieder her. Dafür braucht es ein eigenes Redundanzkonzept.
Ein erfolgreicher Routing-Failover beweist deshalb noch keine nahtlose Übernahme zustandsbehafteter Dienste.
Automatische Umschaltung und unterbrechungsfreier Betrieb sind nicht dasselbe.
Wie lange dauert die Umschaltung?
Eine pauschale Zeitangabe wäre ohne konkretes Fehlerbild und Messung unseriös.
Zur Wiederherstellung gehören mehrere Vorgänge: die Fehlererkennung, die Auswahl beziehungsweise Bekanntmachung von Ersatzpfaden, die Aktualisierung der Forwarding-Tabellen und die Wiederherstellung der Erreichbarkeit in beiden Richtungen.
Ein Teil davon läuft parallel. Trotzdem gibt es keinen einzelnen „Failover-Timer“, der das gesamte Verhalten beschreibt. Für belastbare Aussagen muss die tatsächliche Paketweiterleitung gemessen werden – nicht nur der Zeitpunkt eines BGP-Logeintrags.
Unser Maßstab ist deshalb nicht die kleinstmögliche Zahl in einem Datenblatt, sondern das Verhalten eines konkreten Dienstes bei einem konkreten Fehler.
Die gezeigten Filter erklären, welche Pfade verwendet werden dürfen und wie sie priorisiert werden. Aus ihnen allein lässt sich keine garantierte Umschaltzeit ableiten.
Echte Redundanz braucht unabhängige Wege – und ausreichende Kapazität
Zwei Verbindungen sind nur gegenüber den Fehlern redundant, die nicht beide gleichzeitig treffen.
Laufen zwei Carrier-Anbindungen über denselben Switch, bleibt dieser Switch ein gemeinsamer Ausfallpunkt. Teilen sich zwei Glasfaserwege dieselbe Trasse, kann eine einzige Beschädigung beide betreffen. Werden mehrere Internet Exchanges über dieselbe Transportstrecke erreicht, hängt ihre lokale Erreichbarkeit weiterhin an dieser Strecke.
Die entscheidende Planungsfrage lautet deshalb:
Welches einzelne Ereignis kann alle vorgesehenen Alternativen gleichzeitig ausschalten?
Dazu kommt die Kapazität.
Ein vereinfachtes Rechenbeispiel: Zwei Anbindungen mit jeweils 10 Gbit/s transportieren zusammen 16 Gbit/s. Fällt eine davon aus, passen diese 16 Gbit/s nicht plötzlich durch die verbleibenden 10 Gbit/s.
Das Routing kann dabei vollkommen korrekt umschalten. Die verbleibende Kapazität reicht trotzdem nicht für dieselbe Last.
Zur Redundanzplanung gehört deshalb nicht nur ein erreichbarer Ersatzpfad, sondern auch die Frage, welche Last dieser Pfad im Fehlerfall tatsächlich tragen soll.
Und die Grenze bleibt klar: Redundante Internet-Uplinks im Provider-Netz ersetzen keine zweite Kundenanbindung. Ist die einzige Leitung zum Kundenstandort unterbrochen, löst ein zusätzlicher Transit am anderen Ende des Netzes dieses Problem nicht.
Ein Failover ist erst dann belastbar, wenn der Dienst getestet wurde
Ein aussagekräftiger Test muss mehr beantworten als die Frage, ob eine andere Route aktiv geworden ist.
Wie viel Paketverlust entsteht? Funktionieren bestehende und neue Verbindungen? Ist der Anschluss weiterhin von außen erreichbar? Wie verhalten sich größere Datenübertragungen unter Last? Und funktioniert auch die Rückkehr in den Normalbetrieb?
Dabei müssen unterschiedliche Fehlerfälle getrennt betrachtet werden: Ein administrativ beendetes BGP-Peering ist nicht derselbe Test wie ein physischer Linkverlust oder eine unerreichbare Gegenstelle bei weiterhin aktivem Port. Entsprechend unterscheiden auch standardisierte BGP-Konvergenztests diese Ereignisse.
Gerade bei alternativen Transportwegen lohnt außerdem ein genauer Blick auf die MTU. Kleine Pings können funktionieren, während größere TCP-Übertragungen aufgrund eines Path-MTU-Problems hängen bleiben. „Ping geht“ ist deshalb kein ausreichendes Abnahmekriterium.
Bei angekündigten Wartungen lässt sich der Verkehr zudem häufig vorab auf andere Wege verlagern. Verfahren wie Graceful BGP Shutdown sind dafür gedacht, die Auswirkungen geplanter Abschaltungen zu reduzieren. Ein plötzlich unterbrochenes Kabel bietet diesen Vorlauf nicht.
Fazit: Das Kabel darf ausfallen. Der Plan dafür sollte vorher stehen.
Ein Uplink-Ausfall ist nicht der Moment, in dem ein redundantes Netz seine Alternative erst erfinden sollte.
Die Ersatzanbindungen müssen bereits funktionieren. Die Importfilter müssen brauchbare Alternativen zulassen und unzulässige Routen ausschließen. Die Routing-Policy muss die gewünschte Pfadauswahl abbilden. Die Exportfilter müssen unsere Erreichbarkeit über die verbleibenden Anbindungen ermöglichen, ohne fremde Netze unbeabsichtigt weiterzuverteilen.
Dazu kommen der interne Transport, der Rückweg, mögliche Verbindungszustände und ausreichend Kapazität.
Genau darin liegt für uns der Unterschied zwischen mehreren Anschlüssen und einer belastbaren Netzarchitektur.
Redundanz verhindert nicht, dass etwas kaputtgeht. Sie begrenzt, was dadurch ebenfalls ausfällt.
Die Antwort auf „Das Kabel ist weg – und jetzt?“ sollte deshalb nicht lauten: „Wir überlegen uns eine Lösung.“
Sondern: „Der vorgesehene Ersatzweg übernimmt – innerhalb derselben klar definierten Routing- und Sicherheitsregeln wie im Normalbetrieb.“

